Immobiliendaten aus verschiedenen Quellen sehen auf den ersten Blick ähnlich aus. In der Praxis unterscheiden sich Bezeichnungen, Kategorien, Ortsangaben, Flächen, Preise, IDs, Bilder und Aktualisierungszyklen erheblich. ImmoCheck Paraguay wurde deshalb nicht nur als Immobilienplattform, sondern als Datenprojekt aufgebaut.
Die Ausgangslage
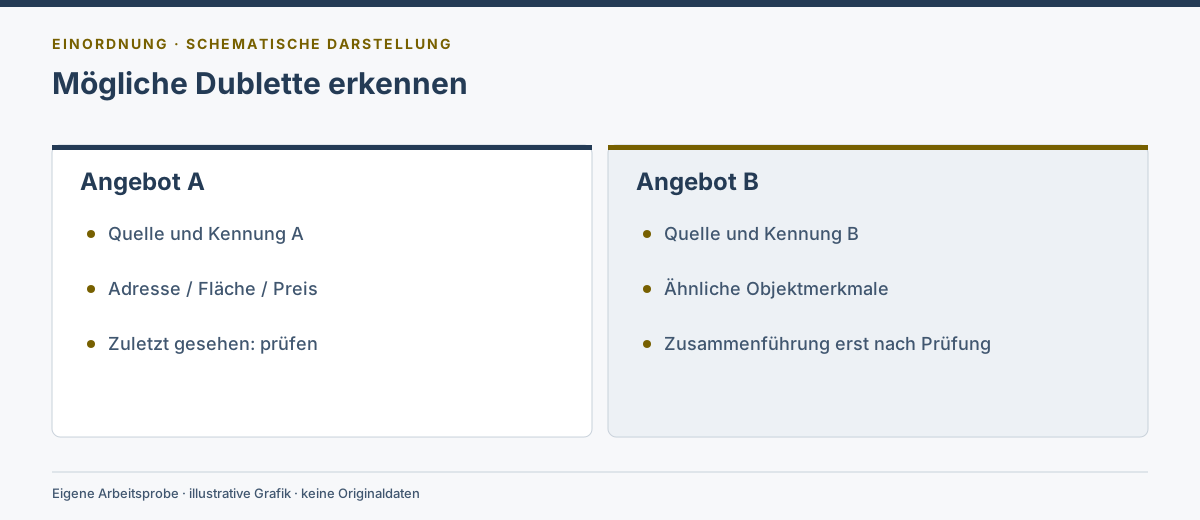
Angebote und Projektinformationen stammen aus unterschiedlichen Marktquellen. Dieselbe Immobilie kann mehrfach erscheinen, einmal mit anderer Schreibweise, anderem Preis oder leicht abweichenden Flächen.
Manche Objekte verschwinden, andere werden aktualisiert. Projekte, einzelne Wohnungen und Bauträgerinformationen liegen in unterschiedlichen Strukturen vor.
Eine große Zahl importierter Datensätze sagt deshalb noch nichts darüber aus, wie aktuell oder verlässlich der tatsächliche Marktbestand ist.
Die eigentliche Aufgabe beginnt nach dem Import
Daten werden je nach Quelle über strukturierte Schnittstellen, Importe oder automatisierte Datenerhebung eingelesen.
Danach müssen sie normalisiert, identifiziert und miteinander verglichen werden. Erst dann lässt sich entscheiden, ob zwei Datensätze dasselbe Objekt beschreiben, welche Angabe aktueller ist und ob die Information überhaupt veröffentlicht werden sollte.
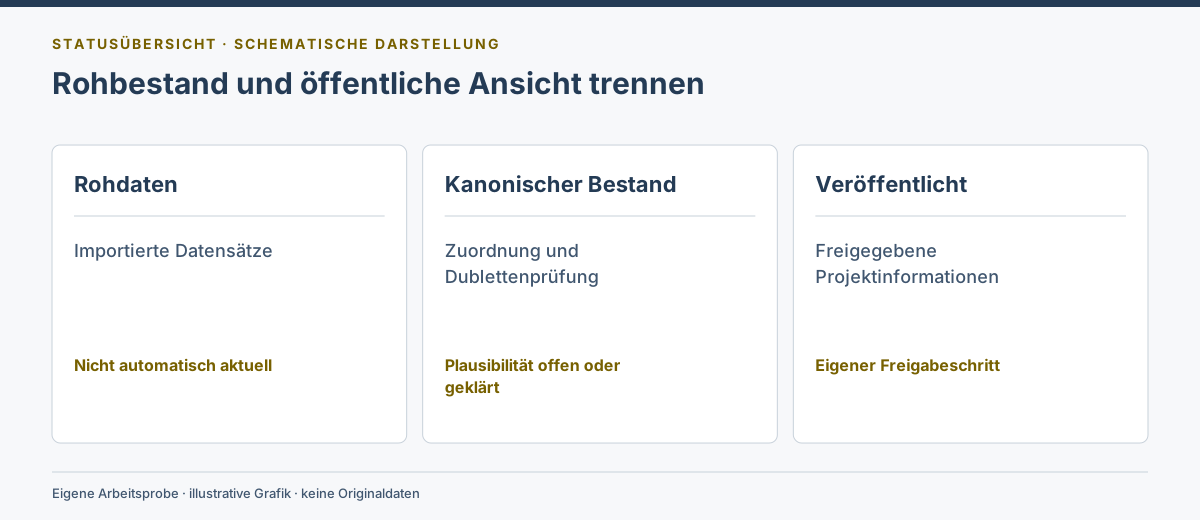
Technische Erfassung und öffentliche Veröffentlichung werden bewusst getrennt betrachtet.
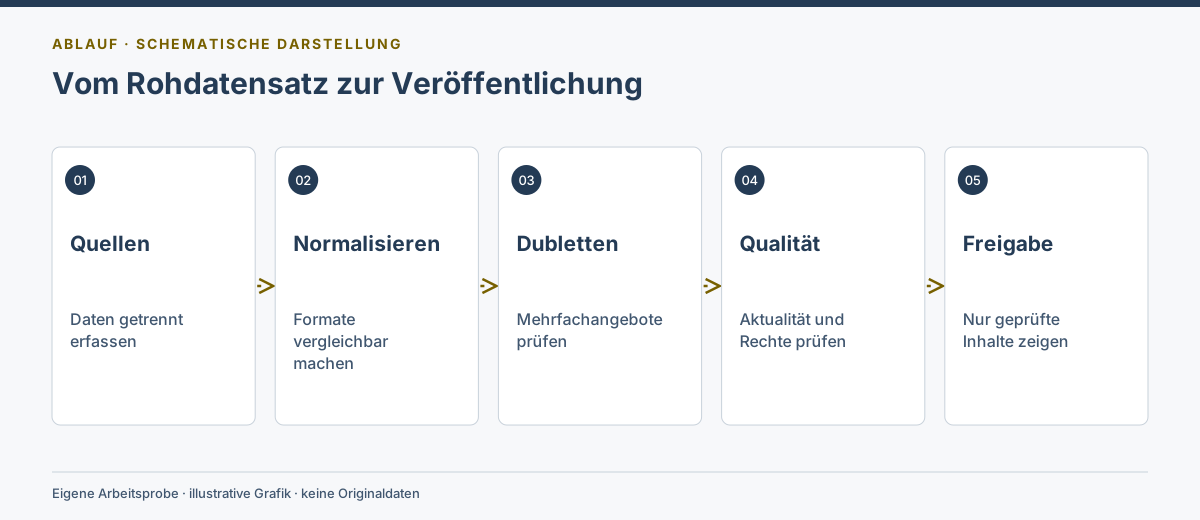
Unser Datenprozess
- Daten aus unterschiedlichen Quellen erfassen.
- Felder und Formate normalisieren.
- stabile Identifikatoren und Quellbezüge sichern.
- Dubletten und mögliche Mehrfachangebote erkennen.
- Datensätze zusammenführen oder getrennt halten.
- Preise, Flächen und andere Kerndaten auf Plausibilität prüfen.
- Aktualität und letzte Sichtung dokumentieren.
- Projekte, Bauträger und Einheiten miteinander verknüpfen.
- Daten- und Bildfreigaben getrennt berücksichtigen.
- Nur den dafür vorgesehenen Bestand veröffentlichen.
Warum wir Rohbestand und Veröffentlichung trennen
Der interne Datenbestand umfasst inzwischen mehr als 50.000 erfasste Immobilienobjekte. Diese Zahl ist aber ausdrücklich nicht gleichbedeutend mit '50.000 aktuell verfügbaren Immobilien'.
Ein Datensatz kann alt, doppelt, unvollständig oder nur für interne Marktrecherche geeignet sein.
Deshalb gibt es eine bewusste Trennung zwischen Rohdaten, kanonisch zugeordneten Datensätzen, qualitätsgeprüften Projektinformationen und dem öffentlich freigegebenen Bestand.
Das Ergebnis
Aus einer großen Menge heterogener Rohdaten entsteht schrittweise ein nachvollziehbarer Datenbestand.
Für zentrale Informationen bleibt erkennbar, aus welcher Quelle sie stammen, wann sie zuletzt gesehen wurden und ob es mögliche Dubletten oder Widersprüche gibt.
Der Wert liegt damit nicht in der reinen Menge der gesammelten Daten, sondern in der Fähigkeit, unterschiedliche Informationen so aufzubereiten, dass sie vergleichbar und kontrollierbar werden.
Was daran übertragbar ist
Das gleiche Grundproblem gibt es in vielen Unternehmen: Produktdaten, Lieferantendaten, Adressbestände, CRM-Dubletten, Preislisten oder Informationen aus mehreren externen Quellen.
Wer Daten automatisiert einsammelt, braucht deshalb gleichzeitig Regeln für Herkunft, Aktualität, Dubletten, Plausibilität und Freigabe. Sonst wird aus mehr Daten nur mehr Unordnung.
„50.000 Datensätze einzusammeln ist technisch interessant. Entscheidend ist, aus ihnen Informationen zu machen, denen man vertrauen kann.“